
Jour 1 – Comprendre et utiliser Spark 4
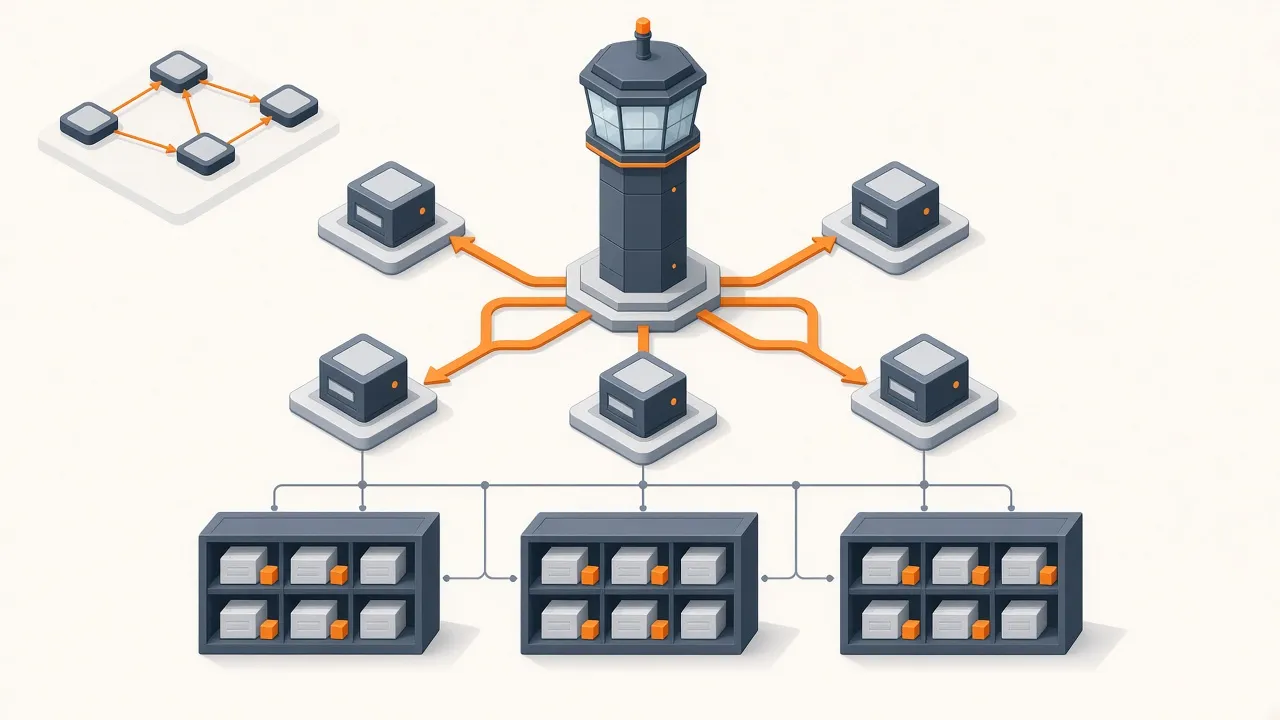
Et si vous deviez analyser 10 ans de courses de taxi… avec Excel ? Comment feriez-vous ?
La première journée installe les fondations : pourquoi le calcul distribué, comment Spark exécute votre code, où vivent les données sur un cluster, et pourquoi on écrit aujourd’hui des DataFrames plutôt que des RDD. Une seule question métier, résolue trois fois pour comparer : quelles zones de New York rapportent le plus, et à quelle heure ?
Objectifs du jour
Section intitulée « Objectifs du jour »À la fin de la journée, vous saurez :
- Expliquer pourquoi une seule machine ne suffit plus et ce qu’apporte Spark par rapport à MapReduce.
- Installer Spark 4 en local et lire la Spark UI (jobs, stages, tâches).
- Manipuler des RDD et PairRDD, distinguer transformations et actions, repérer un shuffle.
- Décrire HDFS (NameNode, DataNodes, blocs, réplication) et le rôle de
core-site.xml/hdfs-site.xml. - Lancer le même job en local puis sur un cluster Standalone avec
spark-submit. - Écrire une requête en Spark SQL et en API DataFrame, déclarer un schéma, partitionner une écriture.
Objectifs couverts : 1, 3, 4, 5, 7 et 8 (voir la page Programme).
- Accueil, tour de table (prénom, attentes, contexte, outils), objectifs, règles du jeu
- Partie 1 – Big Data, calcul distribué et premiers pas avec Spark 4
- TP 1 – Premier contact (30 min)
- Pause
- Partie 2 – Spark Core : RDD, PairRDD et exécution
- TP 2 – Top 10 des zones avec les RDD (30 min), partage, quiz express
- Émargement, déjeuner
- Partie 3 – Hadoop, HDFS et Spark sur un cluster
- TP 3 – Le fil rouge sur un cluster + HDFS (50 min)
- Pause
- Partie 4 – Structured API et Spark SQL
- TP 4 – Le fil rouge en Spark SQL (45 min)
- Ce qu'il faut retenir, attentes couvertes, émargement
Règles du jeu
Section intitulée « Règles du jeu »- Mode solution : on cherche, on essaie, on se trompe, on recommence.
- Participer : « Qui a réussi ? » n’est pas une question piège.
- Droit à l’erreur : les pièges des TP sont là pour être rencontrés (le
joinvide du TP 2, par exemple). - Écoute active, smartphone posé.
- 60 % de pratique, 40 % de théorie, un seul projet fil rouge.
Ce qu’il faut retenir de la journée
Section intitulée « Ce qu’il faut retenir de la journée »| Idée | En une phrase | |
|---|---|---|
| 1 | Diviser pour régner | Des partitions, du calcul là où sont les données, en parallèle et en mémoire. |
| 2 | Paresseux jusqu’à l’action | Les transformations construisent un plan. 1 action = 1 job, 1 shuffle = 1 nouveau stage. |
| 3 | Un seul point d’entrée | SparkSession. SQLContext et HiveContext sont de l’héritage à savoir lire. |
| 4 | Qui fait quoi | Le Driver planifie, le Cluster Manager alloue, les Executors exécutent, HDFS stocke par blocs. |
| 5 | DataFrames d’abord | Schéma explicite, SQL ou API : Catalyst optimise. Les RDD pour les cas spéciaux. |
Pour réviser : la fiche mémo du jour 1 et les quiz 1 à 4 de la section révision.
Demain matin : 10 minutes de questions-réponses sur ces 5 points, puis aide pour finir le TP 4. Les corrigés sont publiés sur le dépôt Git ce soir.
Dépôt des participants : formations2026/formation-spark-ml (branche participants)
Contenu pédagogique © Ambient IT · 140 Avenue Jean Lolive, 93500 Pantin · formation@ambient-it.net · +33 (0)1 48 10 09 46
Organisme de formation enregistré sous le numéro 11 75 54743 75. Cet enregistrement ne vaut pas agrément de l'État.